LLMOとは?AI検索に引用されるためにECサイトでやること
呼び方が4つあって迷う話から、AIクローラーの通し方、構造化データ、サイトの外での評判、自分でできる診断まで。ECサイト向けにまとめました。
AI検索の話をしていると、LLMO、AIO、GEO、AEOと呼び方が出てきて、どれを使えばいいのか分からなくなります。まずはそこから整理して、そのうえでECサイトとして何をするのかをまとめます。
先に結論を書くと、やること自体はSEOの延長です。ただし「AIのクローラーを通しているか」「商品情報が機械に読める形になっているか」「引用されたかを測れているか」の3つは、これまでのSEOでは意識しなかった部分です。
LLMO・AIO・GEO・AEO、どれを使えばいい?
指しているものはほぼ同じです。AIが作る回答の中に自社の情報を入れてもらう、という取り組みを、それぞれ別の角度から名づけたものです。
| 呼び方 | 正式名称 | 直訳 |
|---|---|---|
| LLMO | Large Language Model Optimization | 大規模言語モデル最適化 |
| AIO | AI Optimization | AI最適化 |
| GEO | Generative Engine Optimization | 生成エンジン最適化 |
| AEO | Answer Engine Optimization | 回答エンジン最適化 |
では実際にどれが使われているのか。2026年9月時点で、日本語の月間検索数を調べました。
| キーワード | 月間検索数(日本) |
|---|---|
| LLMO | 12,100 |
| AIO とは | 5,400 |
| LLMO とは | 4,400 |
| AIO 対策 | 4,400 |
| LLMO 対策 | 2,900 |
| GEO 対策 | 1,600 |
| AEO 対策 | 880 |
日本語では LLMO が頭ひとつ抜けています。 単体で12,100あり、検索結果もAI検索対策の記事で埋まっていて、意味が1つに定まっています。
一方で、英語圏では事情が違います。同じ時期に米国・英語で調べると、こうなります。
| キーワード | 月間検索数(米国) |
|---|---|
| generative engine optimization | 4,400 |
| geo vs seo | 2,900 |
| answer engine optimization | 2,400 |
| llmo | 480 |
英語圏の主流は GEO で、LLMO は480しかありません。 LLMOはほぼ日本固有の呼び方だと考えてよさそうです。海外の情報を追うときは GEO や AEO で検索したほうが見つかります。
AEO には注意点があります
「AEO」単体の検索数は4,400ありますが、検索結果のほとんどは税関の「AEO制度(Authorized Economic Operator/認定事業者)」です。税関・財務省・物流会社のページが上位を占めていて、AI検索の話は上位に1件あるだけでした。
日本語で「AEO対策をやりましょう」と言うと、貿易実務の人には別の意味で伝わります。社外向けの資料では避けるか、初出で「AI検索対策(AEO)」と補足するのが無難です。
なお、なぜLLMOが残ったのかについては、AIOはGoogleの「AI Overviews(AIによる概要)」と略語がぶつかり、GEOは社名(ゲオ)と読みがぶつかる、という説明を各社がしています。消去法という側面はありそうです。
結論としては、厳密な使い分けに実益はほとんどありません。大事なのは社内とお客さまとの間で呼び方を1つに決めることです。この記事ではLLMOで統一します。
SEOとLLMOの違い
| SEO | LLMO | |
|---|---|---|
| 目指すもの | 検索結果で上位に出る | AIの回答の中に引用される |
| 成果の形 | クリックされて流入する | 引用され、指名で来る/クリックされないこともある |
| 主な戦場 | 自社サイト | 自社サイト+第三者のメディアや比較サイト |
| 測り方 | 表示回数・順位・クリック | 引用回数・リファラ・アンケート |
大きな違いはクリックされないことがある点です。AIの回答だけで用が足りると、そのまま離れます。それでも、回答の中で名前が出ていれば後から指名で検索されることがあるので、効果はクリック数だけでは測れません。
もうひとつ、自社サイトの外が効くのもSEOと違うところです。AIは複数の情報源から回答を作るので、比較サイトやメディアでどう書かれているかも引用のされ方に影響します。どのくらい効くのかは、後半の「サイトの外での評判(サイテーション)を増やす」に数字を載せています。
AI検索に引用されるまでの流れ
引用されるには、順番に3つの関門があります。
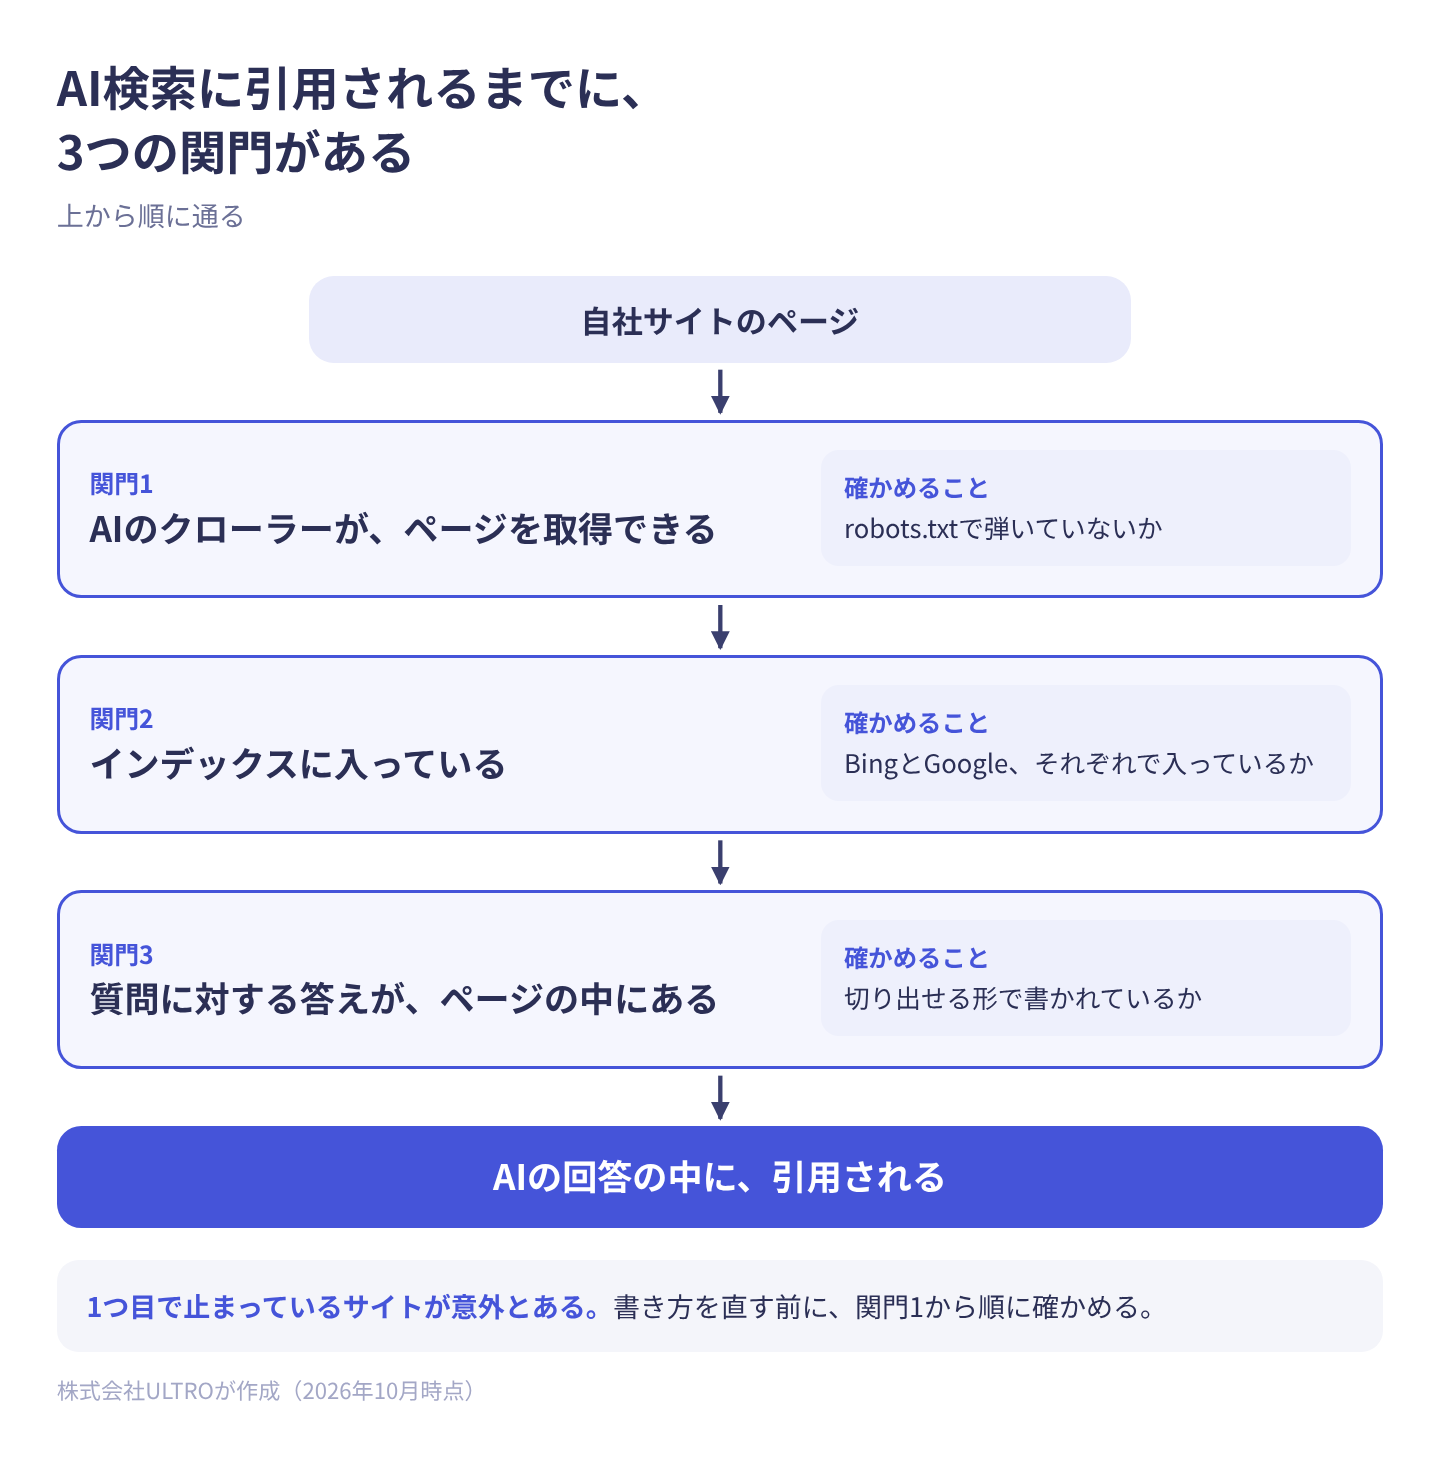
- AIのクローラーがページを取得できる(robots.txtで弾いていないか)
- インデックスに入っている(Bing・Googleそれぞれ)
- 質問に対する答えがページの中にある(切り出せる形で書かれているか)
1つ目で止まっているサイトが意外とあります。順に見ていきます。
AIクローラーを通しているか確かめる
ここがLLMOで最初にやることです。AIのクローラーは会社ごと、しかも用途ごとに分かれています。
| ユーザーエージェント | 提供元 | 用途 |
|---|---|---|
| GPTBot | OpenAI | 生成AIモデルの学習に使うコンテンツの収集 |
| OAI-SearchBot | OpenAI | ChatGPTの検索結果に表示するための取得 |
| ChatGPT-User | OpenAI | ユーザーの質問に応じてページを見にくる |
| ClaudeBot | Anthropic | モデルの学習に使うコンテンツの収集 |
| Claude-SearchBot | Anthropic | 検索結果の品質向上のための巡回 |
| Claude-User | Anthropic | ユーザーの質問に応じたウェブアクセス |
| Google-Extended | Geminiの学習と、Geminiでのグラウンディングの可否を制御 |
注目してほしいのは、学習用と検索用が別になっていることです。OpenAIの公式ドキュメントにも、GPTBotは許可してOAI-SearchBotは弾く(あるいはその逆)といった設定ができると書かれています。
つまり、学習に使われるのは避けたいが、AI検索には出てほしいという判断ができます。ECサイトなら後者を取りたい場面が多いはずです。
Google-Extended は少し性質が違って、専用のユーザーエージェント文字列を持ちません。robots.txtでの制御用のトークンで、Geminiの学習とグラウンディングの可否を決めます。Google検索のインデックスやランキングには影響しない、と公式に明記されています。
ほかにも PerplexityBot、Applebot-Extended、CCBot などがあります。
robots.txt の書き方
「AI検索には出したい、学習には使わせたくない」なら、こういう書き方になります。
# 学習用は不許可
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

# 検索の参照用は許可(明示しておく)
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /逆に、引用されることを優先するなら何も弾かないのが素直です。大事なのは、意図せず全部弾いていないかを確認することです。https://ドメイン/robots.txt をブラウザで開いて、User-agent: * に Disallow: / が付いていないか見てください。
Shopifyの場合は、テーマの robots.txt.liquid で編集します。管理画面の「オンラインストア」→「テーマ」→ コードを編集 → テンプレートに robots.txt.liquid を追加して書き換えます。追加していない状態ではShopifyの既定値が使われます。
ECサイトの構造化データ
AIは、ページのテキストだけでなく構造化データも読みます。商品情報は文章より構造化データのほうが確実に伝わるので、ECではここが効きます。
使う型は主に4つです。
| 型 | 何を伝えるか |
|---|---|
| Product | 商品名、ブランド、型番、画像、説明 |
| Offer | 価格、通貨、在庫の有無 |
| AggregateRating / Review | レビューの平均点と件数 |
| FAQPage | よくある質問と、その答え |
商品ページに入れるJSON-LDは、最小限だとこの形です。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "商品名",
  "image": ["https://example.com/photo.jpg"],
  "description": "商品の説明",
  "brand": { "@type": "Brand", "name": "ブランド名" },
  "offers": {
    "@type": "Offer",
    "url": "https://example.com/products/xxx",
    "priceCurrency": "JPY",
    "price": "4800",
    "availability": "https://schema.org/InStock"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.6",
    "reviewCount": "128"
  }
}
</script>Shopifyは多くのテーマがProductの構造化データを最初から出しますが、レビューはアプリ任せなので入っていないことがあります。まずはいまの商品ページで何が出ているかを確認してください。Googleのリッチリザルト テストにURLを入れると、検出された型が一覧で出ます。
FAQPage は商品ページにもカテゴリページにも足せます。「サイズはどう選べばいいですか」「返品はできますか」といった、実際に問い合わせが来る質問をそのまま入れるのが確実です。AIは質問に答えるので、質問の形で書いてある情報は引用されやすくなります。
Shopifyなら Knowledge Base も見る
ここまでは自分のページに何を書くかの話でした。Shopifyを使っている場合、ページの外側にもう1つ、AIに渡す情報の置き場があります。Shopify Knowledge Base という無料アプリです。
役割が構造化データとは違います。構造化データは自分のページに埋めてクローラーに読ませるもの。Knowledge Base のFAQはページには表示されず、AI側に渡すために書くものです。Shopifyのヘルプにもそう書かれています。
FAQはストアフロントには直接表示されません。かわりに、AIプラットフォームがストアについて正確な回答を生成するための信頼できるデータソースとして機能します
アプリストア側の説明も「買い物客がAIエージェントを使って商品を探したり、ストアのポリシーについて質問したりしたとき、Shopifyはストアのカタログと設定をもとに回答を提供します」となっていて、特定のチャットアプリの話には限定していません。
使いどころは Query log です。 お客様や AI エージェントから来た質問と、どのFAQに当たったかが残り、当てはまるものがなければ Unanswered と表示されます。ここに出てくるのは、聞かれているのに答えを用意できていない項目のリストです。憶測でFAQを書くより、ここを潰すほうが早く効きます。
ただし、どのAIプラットフォームがこのFAQを読むのかは名指しされていません。Shopify Catalog のヘルプで、AIチャネルに共有されると明記されているのは商品データ(タイトル・説明・画像・価格・オプション・在庫)で、FAQは列挙されていません。Shopifyが仲介するAIチャネルで効く可能性は高いと考えていますが、これは推測です。Google検索やChatGPTの回答にFAQの文面がそのまま出る、という保証はありません。
手間が小さいわりに、外れたときの損もない部類です。設定手順と Query log の使い方はShopify Inboxの使い方|AIエージェントの設定と運用の要点にまとめています。
 ULTRO NOTES|サイト構築・改善Shopify Inboxの使い方|AIエージェントの設定と運用の要点Shopify Inboxの設定手順を管理画面のキャプチャで解説します。AIエージェントのペルソナ、回答の元になるKnowledge BaseとQuery logの使い方、任せていい問い合わせの線引き、有人対応が必要な場合の選択肢までまとめました。FAQはInbox以外のAIエージェントも参照する前提で作られています。
llms.txt は今どうなのか
llms.txt は、サイトの内容をAI向けにまとめたテキストファイルをルートに置く、という提案です。
現時点では、置いても損はないが、効果が保証されているわけではないという位置づけです。Googleからは、llms.txtを読み込んでいるAIシステムは確認できていないという趣旨の発言も出ています。主要なAIが正式に参照していると公式に案内しているものは、いまのところ見当たりません。
ULTROのこのサイトでも /llms.txt を自動生成して出していますが、これ単体で引用が増えるとは考えていません。手間がほぼゼロなので出している、という程度の話です。
優先順位でいえば、robots.txtの確認と構造化データのほうが先です。
引用されやすい書き方
3つ目の関門、質問に対する答えがページの中にあるの話です。ここは感覚論になりがちですが、参考になる分析があります。
Kevin Indig が2026年2月に公開したもので、ChatGPTの回答300万件・引用3,000万件から18,012件の引用を抜き出して、ページのどこが引かれているかを調べています。
結果を先に図で示します。
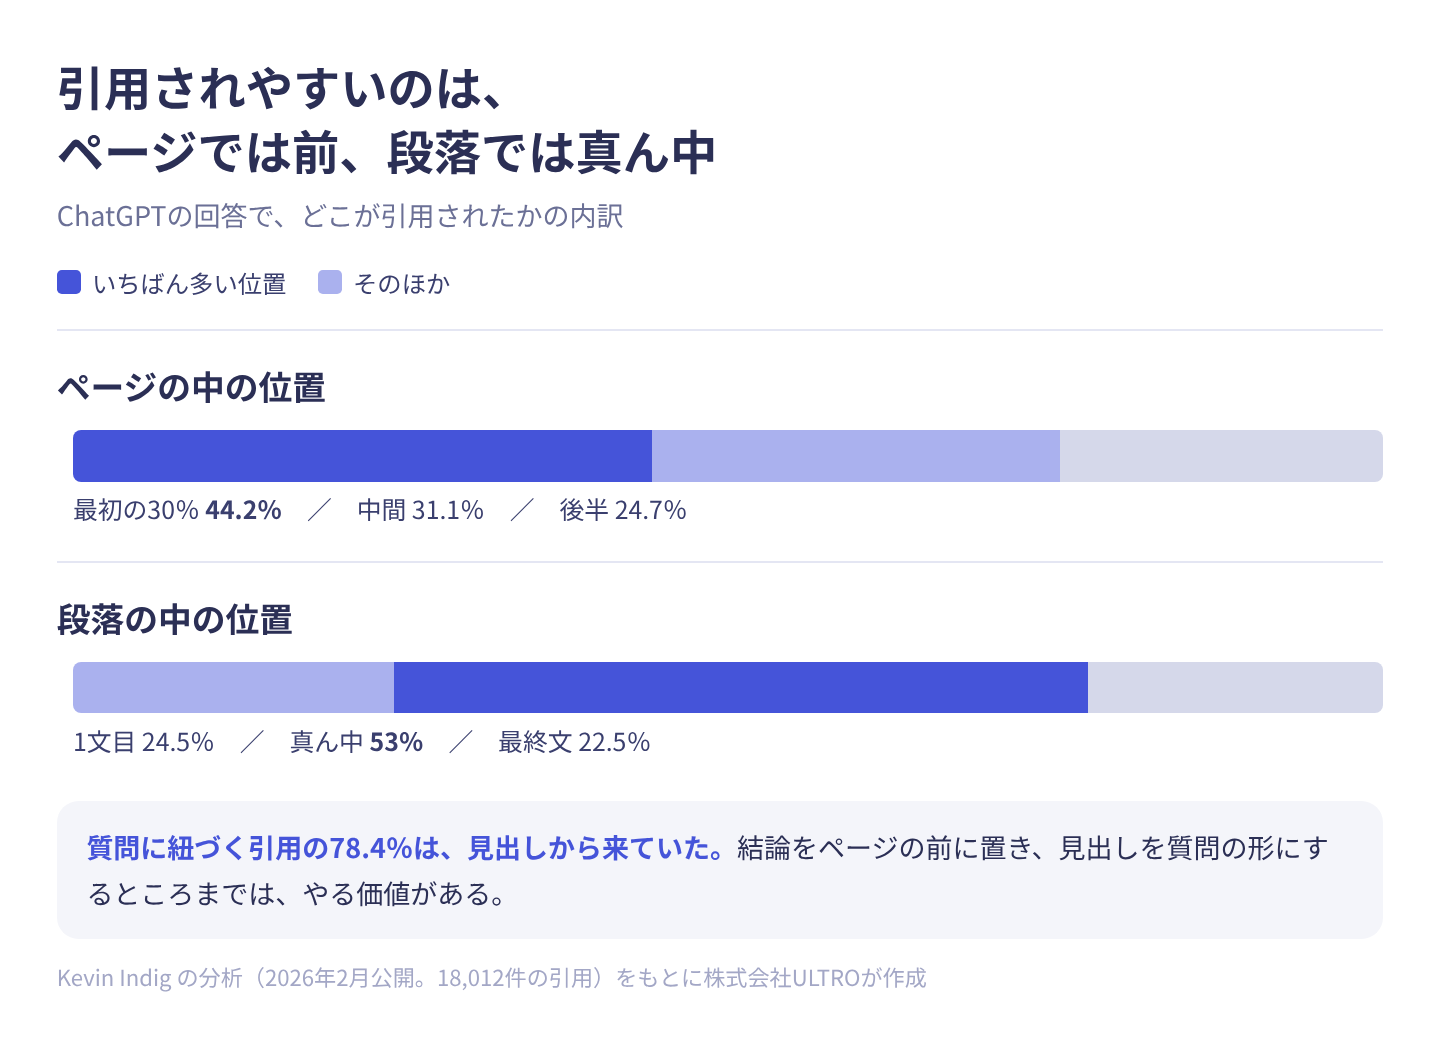
ページの中の位置を表にすると、次のとおりです。
| 引用された箇所 | 割合 |
|---|---|
| ページの最初の30% | 44.2% |
| 中間(30〜70%) | 31.1% |
| 後半3分の1 | 24.7% |
ページの前のほうが引かれやすいということです。結論を最後に置く構成は、AI検索では不利になります。
見出しについても数字が出ていて、引用されたコンテンツは疑問符を含む確率が2倍、さらに質問に紐づく引用の78.4%が見出しから来ていました。AIが見出しを質問として読み、その下の段落を答えとして拾っている、と考えると説明がつきます。
一方で、段落の中のどこが引かれるかを見ると、53%は段落の真ん中で、1文目は24.5%、最終文は22.5%でした。「各段落の1文目に結論を置く」といった文単位の指南は、この数字とは噛み合っていません。ページ単位で前に置く・見出しを質問にする、まではやる価値がありますが、そこから先の小細工は根拠が薄いと考えています。
FAQを構造化データで出すのも同じ理屈です。質問と答えのセットは、機械から見ていちばん切り出しやすい形になっています。このサイトでは各記事のFAQをFAQPageのJSON-LDで自動出力していて、この記事にも6問入れています。なお、GoogleのFAQリッチリザルト(検索結果にQ&Aが展開される表示)は2026年5月7日に廃止されました。廃止されたのは表示のほうだけで、FAQPageの構造化データ自体は有効なままです。Googleも「マークアップは残しておいてよい。問題は起きないが、検索結果には出ない」という趣旨の案内をしています。質問と答えが機械に読める形で並んでいること自体には、引き続き意味があります。
まとめると、やることは3つです。
- 結論を冒頭に置く(ページの前30%に答えがある状態にする)
- 見出しを質問形式にする(読者が検索窓に打つ言葉で書く)
- FAQを構造化データで出す
いずれも引用のされやすさの話で、順位が上がる保証ではありません。ただ3つとも読者にとっても読みやすい書き方なので、AI向けに文章を不自然にする必要はない、というのが実際のところです。
サイトの外での評判(サイテーション)を増やす
ここまでは自社サイトの中の話でした。ただ、AIが回答を作るときに読むのは自社サイトだけではありません。第三者のサイトで名前が挙がること(サイテーション)が、引用や推奨にかなり効きます。
AIはどこを参照しているか
『60分でわかる!LLMO超入門』は、Web上の情報を広告(Paid)・第三者の評価や報道(Earned)・SNS(Shared)・自社メディア(Owned)の4つに分けて説明しています。同書が紹介している調査では、ChatGPTなどのAI検索の回答は情報源の大半が第三者の評価や報道で、自動車業界を対象にした調査では参照元の約70〜80%を占めていました。
ただし、検索の意図によって変わるとも書かれています。
| 検索の意図 | 参照されやすい情報源 |
|---|---|
| 比べて選びたい(「〇〇 おすすめ」など) | 第三者のメディア、比較サイト、レビュー |
| 買う先を決めたい(どの商品をどこで買うか) | 自社サイト |
ECに当てはめると、商品ページを整えるのは「買う先を決める」場面に効き、「そもそもどれを選ぶか」の場面では外部での書かれ方が効く、ということになります。
言及の広さと回数
外部での言及がどのくらい効くのかは、『強いLLMO』に著者の会社(株式会社LANY)の分析が載っています。検索上位20記事の中で、Googleの「AIによる概要」で言及されたブランドと、されなかったブランドを比べたものです。
| AIによる概要で言及あり | 言及なし | |
|---|---|---|
| 上位20記事の中での言及回数(キーワードごとの平均を1とした値) | 1.86 | 0.81(約2.3倍の差) |
| そのブランドに触れていたサイトの割合 | 平均35.0% | 平均21.7%(約1.6倍の差) |
AIに選ばれたブランドは、より多くのサイトで、より多くの回数名前が出ていました。自社サイトの順位だけでなく、検索結果全体の中でどれだけ名前が出ているかが問われる、というのが同書の主張です。
ECで現実的に増やせる場所は、次のようなところだと考えています(ここからは推測です)。
- 比較記事やランキング記事への掲載(掲載依頼、サンプル提供)
- レビューサイトやモールのレビュー
- プレスリリース(新商品、調査結果、受賞など)
- 取引先や使っているアプリの導入事例ページ
どれも昔からある広報の仕事です。LLMOのために新しく何かをするというより、広報で出た記事がAIの材料にもなる、と考えるほうが実態に近いと思います。
社名と強みをいつも隣に置く
『60分でわかる!LLMO超入門』は、2つの言葉がセットで出てくること(共起)を、AIは手がかりにしている、と説明しています。社名のすぐ近くに同じ強みが書かれ続けていれば、AIはその2つを結びつけて覚えます。逆に、強みが社名から離れた場所にしか書かれていなければ、結びつきは弱くなります。
同書が「すぐ効く」として挙げているのが、プレスリリースや資料の最後に毎回入れる会社紹介の定型文です。住所と代表者名だけで終わらせず、結びつけたい強みを社名と同じ文に入れます。たとえばECのブランドなら、こういう違いです。
| 会社紹介の定型文の例 | |
|---|---|
| よくある書き方 | 株式会社〇〇は、東京都渋谷区に本社を置き、化粧品の企画・販売を行っています。 |
| 強みを入れた書き方 | 株式会社〇〇は、敏感肌向けに、全成分と配合の理由をすべて公開したスキンケアを販売しています。 |
一度決めたら、プレスリリース、営業資料、メールの署名、採用ページ、会社概要ページで同じ文を使い続けるのがポイントです。言い回しが毎回変わると、結びつきが分散します。
公式サイトとSNSを「同じ会社」として結びつける
もうひとつ、名前が同じでもAIの中では別の存在として扱われていることがあります。同書では、公式サイト、運営しているXのアカウント、第三者が書いた紹介記事が、AIや検索エンジンの中で別々のIDになり、SNSでの評判が会社の評価として積み上がらないケースが紹介されています。
これを防ぐのが、構造化データの sameAs です。公式サイトのOrganization(会社情報)に「これらのアカウントやページは当社と同じ存在です」と書いておきます。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "株式会社〇〇",
  "url": "https://example.com/",
  "logo": "https://example.com/logo.png",
  "sameAs": [
    "https://x.com/example",
    "https://www.instagram.com/example/",
    "https://www.youtube.com/@example"
  ]
}
</script>入れるのは、自社が運営しているアカウントと、会社の公式な登録情報(国税庁の法人番号公表サイトなど)が基本です。同じ名前の別会社が国内外にある場合は特に効きます。ULTROでも、同じ名前の海外のShopify支援会社があるため、国税庁の法人番号公表サイトとgBizINFOの自社のページを sameAs に入れて区別しています。
Shopifyの場合、公式テーマのDawnは、テーマ設定の「ソーシャルメディア」に登録したURLを、Organizationの sameAs として出力します(Dawnのソースコードで確認)。ほかのテーマで同じように出るかはテーマ次第なので、Schema Markup ValidatorにトップページのURLを入れて、Organizationの中に sameAs があるか確かめてください。SNSのURLが空欄のままだと、sameAs も空になります。構造化データ全体の話はリッチリザルトとは?ECで入れる構造化データと、もう出ない3種類にまとめています。
 ULTRO NOTES|SEO・LLMOリッチリザルトとは?ECで入れる構造化データと、もう出ない3種類リッチリザルトの仕組みと、2026年9月時点でGoogleがサポートしている種類・すでに廃止された種類を一次情報で整理しました。ECサイトで優先して入れるものと、入れたあとの確認手順まで解説します。
引用されたかを測る
LLMOでいちばん難しいのが測定です。決定打がないので、3つを併用します。
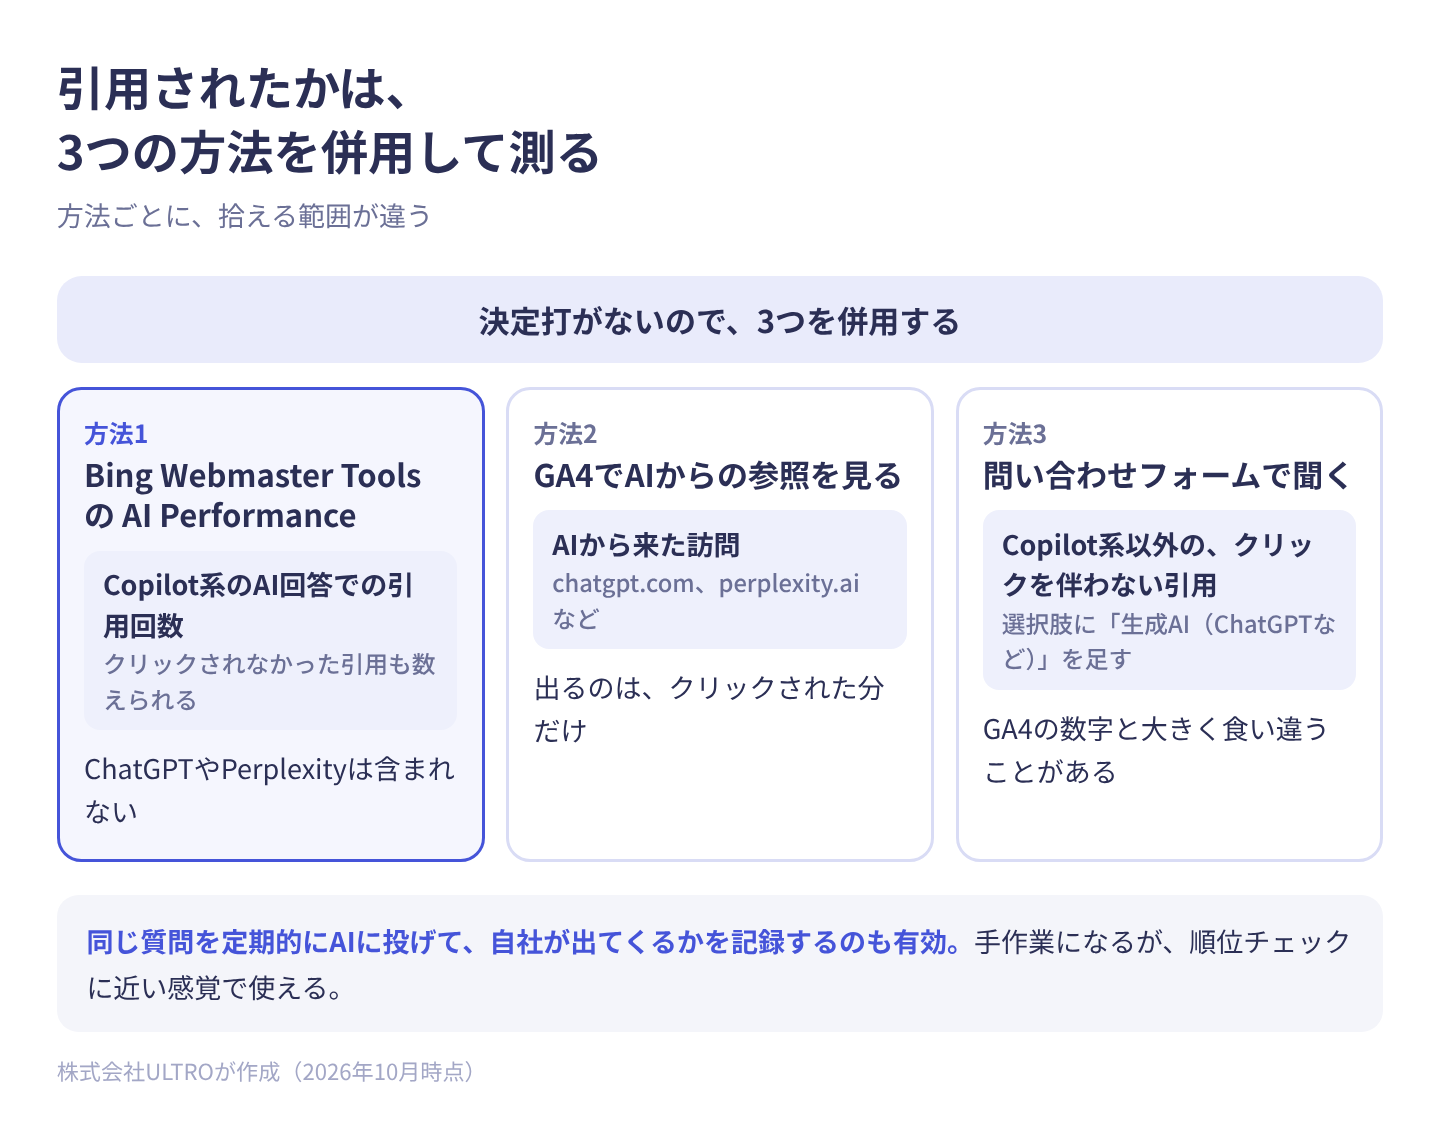
1. Bing Webmaster Tools の AI Performance Copilot系のAI回答で、自社のページが何回引用されたかが出ます。2026年2月に公開された機能で、クリックされなかった引用も数えられるのが大きい点です。対象はMicrosoft CopilotとBingのAI要約、一部のパートナー連携で、ChatGPTやPerplexityは含まれません。
設定と見方はBing Webmaster Toolsの使い方|登録からAI検索の引用確認までにまとめています。
 ULTRO NOTES|SEO・LLMOBing Webmaster Toolsの使い方|登録からAI検索の引用確認までBing Webmaster Toolsの登録方法と使い方を、2026年9月時点の画面でまとめました。Search Consoleからのインポート、URL検査でのインデックス確認、IndexNow、そして2026年2月に追加された「AI Performance」でCopilotに引用された回数を見るところまで解説します。
2. GA4でAIからの参照を見る
参照元に chatgpt.com、perplexity.ai、copilot.microsoft.com、gemini.google.com などが出ます。探索レポートで参照元/メディアを条件にすると、まとめて見られます。ただしここに出るのはクリックされた分だけです。
3. 問い合わせフォームで聞く 「何でULTROを知りましたか」の選択肢に「生成AI(ChatGPTなど)」を足します。地味ですが、ChatGPTやPerplexityなど、Copilot系以外でのクリックを伴わない引用を拾える、いまのところ唯一の方法です。GA4の数字と大きく食い違うことがあります。
4つ目:同じ質問をAIに投げて記録する(自己診断)
3つの方法は、どれも「引用された結果」を後から拾うものです。AIが自社をどう紹介しているかそのものは、自分でAIに聞いてみるのがいちばん早く分かります。手作業ですが、順位チェックに近い感覚で使えます。
やり方は、2冊の本の手順を合わせると次のようになります。
1. 質問のリストを作る お客さんが実際にAIに聞きそうな質問を並べます。『強いLLMO』では50〜100個を勧めていて、どの場面で選ばれたいかによって質問は変わる、としています。小さいお店なら、まず5〜10個で始めても十分だと思います。商品名・社名で聞く質問(「〇〇というブランドについて教えて」「〇〇の評判は?」)も2つほど入れておくと、誤った情報が出ていないかも確かめられます。
2. 毎回フラットな状態で聞く 普段使っているAIは、過去の会話や設定に引っぱられて、こちらの期待に沿った答えを返しがちです。『60分でわかる!LLMO超入門』では、次の3つを挙げています。
| やること | 理由 |
|---|---|
| ブラウザのシークレットモードで、ログインせずに使う | アカウントの履歴や設定の影響を抑える |
| 質問ごとに新しいチャットを開く | 前の質問の流れを持ち込まない |
| 「あなたは〇〇の専門家です」のような役割の指定をしない | 視点を固定すると、普段の答えからずれる |
ただし、これは偏りを小さくする工夫で、AIが学んだデータが変わるわけではない、とも書かれています。
3. ○×と中身の両方を記録する 『強いLLMO』のやり方は、自社が出たかどうかを○×で付けて、○の数÷質問の数を「言及率」として追うものです。同書には、著者の会社がChatGPTに11問を投げ続けた例が載っていて、言及率は2024年8月の36.4%から、2025年3月以降は72.7%まで上がっています。
○だった回答は、中身も見ます。
- 何番目に挙がったか
- 選ばれたい理由と結びつけて勧められているか、名前が並んでいるだけか
- 自社のページや、自社を紹介した記事が引用元に入っているか
- 事実と違う説明(取り扱っていない商品、古い価格、別の会社の情報)が混ざっていないか
4. 月1回、同じ質問で繰り返す AIの答えは、競合の動きやWeb上の情報の更新で揺れ動きます。『60分でわかる!LLMO超入門』は、主な質問は月1回、変化の激しい分野なら隔週を目安にしています。1回の結果で一喜一憂せず、同じ質問を続けて推移を見るのがポイントです。
ULTROでも、2026年10月に、この方法で自社を毎月記録する仕組みを作りました。質問は8つ(Shopifyの構築・保守・広告・CRMの相談先を探す質問6つと、社名で聞く質問2つ)、ChatGPT・Gemini・Perplexity・GoogleのAIモードの4つに、毎月第1月曜に同じ文で聞きます。記録しているのは、出たかどうか、何番目か、どう説明されたか、引用元、同じ名前の別会社と混同されていないか、の5つです。
よくある勘違い
AIに媚びた書き方をすれば引用される そうはなりません。引用されるのは、質問に対して具体的に答えているページです。独自の数字や手順があるページのほうが引かれやすいのは、検索と同じです。
SEOはもう不要になる インデックスされていないページは引用されないので、SEOの土台はそのまま必要です。むしろ前提が増えたと考えるほうが近いです。
AI検索対策をすればすぐ流入が増える 引用されてもクリックされないことがあります。短期の流入で評価すると判断を誤ります。指名検索と問い合わせの経路を一緒に見てください。
計測まわりの下準備
LLMOの話に入る前に、そもそもの計測が整っていないケースは多いです。Search Consoleの権限整理はサーチコンソールの権限とは?種類の違いとユーザーの追加・削除手順にまとめています。
 ULTRO NOTES|SEO・LLMOサーチコンソールの権限とは?種類の違いとユーザーの追加・削除手順サーチコンソールの権限はオーナー・フル・制限付きの3つ。できることの違い、ユーザーを追加・変更・削除する手順、制作会社やSEO会社など外部に渡すときの目安、確認済みオーナーを外すときに残る確認トークンの注意点まで、2026年9月時点の画面でまとめます。
AIクローラーの許可状況や構造化データは、各社の仕様変更で意味が変わります。一度やって終わりにしないために、ULTROでは月次の定点チェックに入れています(攻めの保守)。
参考にした情報
- OpenAI のクローラー(GPTBot / OAI-SearchBot / ChatGPT-User)
- Anthropic のクローラーについて
- Google クローラーとユーザー トリガー フェッチャーの概要
- リッチリザルト テスト
- Schema Markup Validator
- Dawn テーマのソースコード(sections/header.liquid)
- 強いLLMO AI検索で選ばれるためのマーケティングガイド(竹内渓太)
- 60分でわかる!LLMO超入門(出田晴之)
- 44% of ChatGPT citations come from the first third of content(Kevin Indig の分析/Search Engine Land)
- Google Drops FAQ Rich Results From Search(Search Engine Journal)
- 検索数は2026年9月18日にGoogle広告のキーワードプランナーで取得(日本・米国、月間平均)
よくある質問
LLMOとは何ですか?
Large Language Model Optimization の略で、ChatGPTやCopilotなどのAIが作る回答に、自社のページを引用してもらうための取り組みです。検索結果で上位に出すSEOに対して、LLMOはAIの回答の中に入ることを目指します。
LLMO・AIO・GEO・AEOはどう違いますか?どれを使えばいいですか?
指しているものはほぼ同じで、厳密な使い分けに実益はありません。日本語の月間検索数を実測すると、LLMO 12,100/AIO 対策 4,400/GEO 対策 1,600/AEO 対策 880 で、LLMOが最も使われています。社内やお客さまとの会話では、呼び方を1つに決めておくほうが大事です。
SEOとは別に何か新しいことをするのですか?
土台はSEOと同じです。追加で意識するのは、AIのクローラーをrobots.txtで弾いていないか、商品情報が構造化データで機械に読める形になっているか、質問に対する答えがページの中に書かれているか、の3点です。
AIクローラーは学習用と検索用で分かれていますか?
分かれています。たとえばOpenAIは、モデルの学習に使うGPTBotと、ChatGPTの検索結果に表示するためのOAI-SearchBotを別のユーザーエージェントにしています。学習には使われたくないが検索には出てほしい、という設定ができます。
llms.txt は置いたほうがいいですか?
現時点では、置いても損はないが効果は保証されない、という位置づけです。主要なAIが正式に参照しているという公式の案内は見当たりません。ULTROのサイトでは自動生成で出していますが、これだけで引用が増えるとは考えていません。
AI検索で引用されたかは、どうやって測りますか?
3つを併用します。Bing Webmaster Toolsの「AI Performance」でCopilot系での引用回数を見る、GA4で chatgpt.com や perplexity.ai などからの参照を見る、問い合わせフォームの「何で知りましたか」に生成AIの選択肢を足す。クリックされなかった引用は3つ目でしか拾えません。あわせて、決めた質問を月1回、シークレットモードの新しいチャットでAIに投げ、自社が出たか・どう説明されたかを記録すると、AIからの見え方そのものが分かります。
- 呼び方はLLMO・AIO・GEO・AEOの4つ。日本語ではLLMOが最も使われている(実測12,100)
- AEOは税関の認定事業者制度と同じ略語なので、日本語では通じにくい
- 土台はSEOと同じ。追加で見るのはAIクローラー・構造化データ・答えの書き方の3つ
- OpenAIは学習用(GPTBot)と検索用(OAI-SearchBot)でクローラーが分かれている
- ShopifyならKnowledge BaseのFAQも整える。ページに出ないがAI側に渡す情報として設計されている
- AIの回答は第三者の評価や報道を多く参照する。AIによる概要で言及されたブランドは、上位記事での言及回数が約2.3倍あった(『強いLLMO』)
- 会社紹介の定型文に強みを入れて社名とセットで出し続ける。公式サイトとSNSは構造化データの sameAs で同じ会社として結びつける
- 引用の測定はBing Webmaster ToolsのAI Performance、GA4のリファラ、問い合わせ時のアンケートの3本立て
- AIでの見え方は、決めた質問を月1回、シークレットモード・新しいチャット・役割指定なしで投げて記録する
この記事を書いた人永田 龍史
株式会社ULTRO 代表取締役Shopify Partner。Shopifyストアの構築・保守・広告運用・CRMを一気通貫で担当。個人として運用した広告費は累計40億円超。計測設計から逆算して、利益が伸びる仕組みを作っています。Google 広告の認定資格(検索・ディスプレイ・動画・ショッピング・アプリ・P-MAX・測定)と Google アナリティクス認定資格を保有。
経歴と執筆記事81本を見る → Xでフォローする @Ryushi_ULTRO →自分のストアでは、どうなっているか。
無料診断では、あなたのShopifyの実データを見てサイトの健康状態を確認し、何から直すべきかを改善案とあわせてご提案します。